搜狗输入法怎么批量导入专业词汇?2026 实操教程:教你用 TXT 一键导入专属词库!
📅 最后更新:2026年9月14日
✅ 审核:搜狗输入法编辑团队
整理词汇:新建 TXT 记事本,按照“一行一词”整理好你的行业专有名词(建议 2-10 个汉字)。
修改编码:点击“文件” ➔ “另存为”,将文件编码格式强制从默认的 UTF-8 切换为 ANSI(GBK)格式,避免导入后出现一堆乱码。
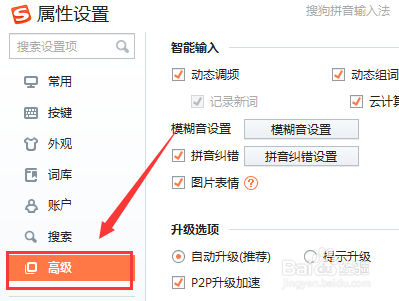
一键导入:右键搜狗输入法状态栏 ➔ 属性设置 ➔ 词库 ➔ 中文用户词库 ➔ 点击 导入 并选择该 TXT 即可完成批量注入。
前段时间,我们团队在整理一份近 4000 条的法律诉讼与合规专有名词库。刚开始新来的实习生在写法律意见书时,敲一个“表见代理诉讼主体”要翻三页候选词,或者分三次拼凑单字。一整天下来,大部分工作时间都消耗在了“选字”这种毫无价值的低效重复劳动上。
如果你也在医疗、IT 架构、金融、工程或法律等专业领域工作,搜狗输入法默认的“通用大众语料”绝对满足不了你。其实,搜狗输入法很早以前就提供了 TXT 文本批量导入用户词库 的功能,只是绝大部分人不知道怎么正确去用,甚至在编码格式上频频踩坑。
今天我就结合自己团队在打造行业专属词库时的实操经验,手把手带你避开所有的坑,用一个简单的 TXT 文件搞定搜狗输入法批量导入!
为什么你必须建立自己的“专属专业词库”?
默认的拼音输入法是基于大众聊天语料训练的。在常规沟通时确实很顺畅,一旦进入特定专业领域,它的表现就会变得非常低效:
-
首选项匹配率低:敲出拼音后,目标词汇往往排在第 8、9 位甚至下一页。
-
打断逻辑思考:每次都要手动选字组合,极度打断写作和思考流程。
-
团队效率无法复用:团队沉淀多年的行业名词,新员工入职后无法直接继承,只能重新挨个“养词”。
通过批量导入自定义 TXT 词库,你可以把高频专业词的打字准确率提升 80% 以上,实现“首字即命中”。
💡 延伸阅读:如果你使用的是鸿蒙设备或新出厂的设备,刚安装完搜狗输入法可能连基本设置都还没调好,可以先参考这篇 鸿蒙原生版搜狗输入法怎么设置?从安装、切换到高级优化全指南 帮你的系统打好基础。
搜狗输入法批量导入专业词汇:SOP 四步实操
你不需要安装任何第三方复杂的转换脚本,Windows 或 Mac 自带的文本编辑器就能搞定。
步骤 1:整理并清洗专业词汇列表
首先,把你的行业词汇提取出来(可以从 Excel 导出,也可以从 Word 整理)。
-
格式规则:一行一个词。搜狗会自动为你解析汉字对应的标准拼音,不需要你额外去标注声调或拼音字母。
-
字数限制:建议词条长度控制在 2 – 10 个汉字 之间。太长(比如一整句公文标语)建议使用搜狗的“自定义短语”功能(快捷短语),而不是走词库。
Plaintext
示例 TXT 内容:
分布式数据库
高并发架构
边缘计算节点
负载均衡策略
步骤 2:最关键的一步!修改 TXT 编码格式为 ANSI
⚠️ 这是 90% 的人在导入时出现问号或乱码的核心原因!
微软记事本(Notepad)保存文件时,默认使用
UTF-8 编码。然而,搜狗输入法的 Windows 本地 TXT 词库解析引擎对 ANSI(中文环境下即 GBK)编码兼容性最好。关于系统字符集的底层映射逻辑,可以参考 Unicode 官方标准文档 (Unicode Consortium) 中关于 CJK 汉字编码转换的相关说明。-
在记事本顶部菜单选择 文件 ➔ 另存为。
-
在弹出的保存窗口底部,找到 编码(Encoding) 下拉菜单。
-
将默认的
UTF-8切换为ANSI。 -
点击保存。
步骤 3:将 TXT 词库批量注入搜狗输入法
文件准备就绪后,打开导入通道:
-
找到搜狗输入法的状态栏(就是那个浮动的小条)。
-
在上面点击 右键,选择 属性设置(或者快捷键
Ctrl + Shift + M打开菜单)。 -
在左侧导航栏点击 词库 选项卡。
-
在右侧找到“用户词库管理”或“中文用户词库”,点击身旁对应的 导入 按钮。
-
浏览并选择你刚才保存好的 ANSI 编码 TXT 文件。
[搜狗输入法状态栏] ➔ (右键) ➔ [属性设置] ➔ [词库] ➔ [中文用户词库: 导入] ➔ 选择 TXT
步骤 4:校验导入结果与生效测试
导入完成后,系统会弹出提示弹窗,显示“成功导入 XXX 条词汇”。
你可以立刻打开一个空白文档,试着输入你刚才导入的专业词汇拼音。你会发现,这些原本不存在于通用字典里的硬核词汇,现在已经稳稳占据了候选词的第 1 位!
真实踩坑记录:3 个隐藏极深的“导入失败”避坑细节
上周我们给团队导入 3500 条法律专有名词时,就遇到了一堆诡异问题。这里把踩坑教训分享出来:
乱码乱成“烫烫烫”或全问号
-
现象:导入提示成功,但打字时候选词显示一堆乱码或全都是方块。
-
真相:100% 是文件保存时用了
UTF-8或UTF-16编码。 -
解法:重新用记事本打开 TXT ➔ 另存为 ➔ 确保右下角编码格式选的是
ANSI➔ 覆盖原文件重新导入。
词汇行里夹带了“不可见特殊符号”
-
现象:TXT 里的词汇明明合法,但导入后搜狗直接跳过,显示“导入 0 条”。
-
真相:从网页、PDF 或 Excel 复制词汇时,结尾经常附带隐藏的
Tab 键 (\t)或全角空格。 -
解法:在记事本中使用
Ctrl + H替换功能,把所有空格、特殊符号批量清空,只保留纯汉字。
多音字拼音自动识别错误
-
现象:导入“重庆”后,打
chongqing出来,打zhongqing也出来,匹配出现偏差。 -
真相:单纯的汉字 TXT 导入依赖搜狗的自动多音字转换算法。
-
高级解法:如果你对拼音精确度要求极高,可以在 TXT 里使用搜狗的标准带拼音词库格式:
chong qing 重庆(拼音在前,中间用半角空格隔开,后面写汉字)。
效率进阶:专业词库 SOP 检查清单
在正式导入前,建议对照以下清单逐项检查,确保一次性通过:
| 检查项目 | 规范要求 | 是否通过 |
| 文件格式 | 纯文本 .txt 文件 |
[ ] |
| 文字排版 | 一行仅包含一个词汇,无空行 | [ ] |
| 词条长度 | 单词长度在 2-10 个汉字之间 | [ ] |
| 特殊字符 | 已清空标点符号、空格及英文括号 | [ ] |
| 文件编码 | 必须为 ANSI 格式(非 UTF-8) | [ ] |
| 词库备份 | 导入后在设置里点击“导出”保存一份做本地备份 | [ ] |
搜狗输入法高阶生产力组合拳
学会批量导入 TXT 专业词汇,只是打造极致输入体验的第一步。如果你想把打字速度再提升一个台阶,建议结合以下方法:
-
同步细胞词库:搜狗官方提供了上万个现成的“细胞词库”(扩展名为
.scel)。比如医学大词典、法律专有词库等,可以直接下载导入,无需自己重新整理 TXT。 -
巧妙运用隐藏快捷键:搜狗输入法内置了大量不为人知的快捷操作(如快速输入物理符号、日期格式化等)。不了解的朋友可以看看这篇总结:还在菜单里翻物理符号?搜狗输入法隐藏快捷键全解析。
-
多端同步:登录搜狗账号后,开启“词库同步”。这样你在电脑端批量导入的这几千条专业词汇,手机端也能同步享受到自动联想的便利!
FAQ:常见问题解答
Q1:为什么我导入的 TXT 文件提示成功,但打字时还是不出词?
A:最常见的原因是词库重合或优先级问题。如果该词汇在通用词库中本身就不常用,它可能被排在了候选词第 2 页。建议在“属性设置 ➔ 词库”中,确认用户词库的优先级已调至最高;或者检查该词汇在 TXT 中是否有语法错误(如混入了特殊标点)。
Q2:搜狗输入法支持一次性导入多少条 TXT 词汇?有上限吗?
A:官方单次导入的 TXT 文件大小建议控制在 10MB 以内(大约相当于几十万条词汇)。单次导入数量过多可能导致输入法短暂卡死。建议如果词库体量巨大(如超过 5 万条),拆分为多个 1 万条左右的小 TXT 文件分批导入。
Q3:搜狗官方的 .scel 细胞词库和我们自己做 .txt 词库有什么区别?
A:
.scel 细胞词库是搜狗官方编译的二进制词库格式,包含了完整的拼音、词频、权重及分类信息;而 .txt 是纯文本词库,操作门槛最低、自定义程度最高。对于公司内部产品名、人名或小众行业术语,自己制作 TXT 词库是效率最高的方式。如果你在批量导入的过程中遇到了其他奇葩报错,欢迎交流排查原因!更多关于输入法效率提升的技巧,也可以访问 搜狗输入法官网探索更多进阶玩法。
Previous: TXT 文本怎么转成搜狗细胞词库(.scel)?2026 最新转换教程与深坑破解
No newer post.